
aimom 后端接口性能优化汇报
一、整体优化思路
本次针对 aimom 后端 [GET] /api/bench:noop 接口的性能优化,遵循"网关层调优 + 后端代码优化"双管齐下的策略:网关层通过连接池参数强化与响应缓冲机制提升转发效率;后端代码层通过降低日志开销、缓存热点计算结果、消除读侧锁竞争,减少单次请求的 CPU 与锁等待时间,从链路的上下游两端同时压降接口响应延迟。
优化迭代流程: Nginx upstream 连接池参数强化 → Nginx 响应缓冲机制启用 → 后端日志降级 → 后端热点计算缓存 → 后端读侧免锁优化 → 性能全面达标
二、优化总览
本次优化围绕 aimom 后端接口链路展开,涉及 Nginx 网关层和后端服务代码层两大方向。以下为各优化点的详细梳理:
| 优化方向 | 核心问题 | 优化动作 | 优化成果 |
|---|---|---|---|
| Nginx upstream 连接池 | keepalive 连接数仅 32,无负载均衡策略,无连接数和超时显式配置,高并发下连接复用率不足 | 连接池扩容至 256,启用 least_conn 负载均衡策略,配置 keepalive_requests 10000 和 keepalive_timeout 300s | 连接复用率大幅提升,负载均衡更均匀,消除连接频繁创建销毁开销 |
| Nginx 响应缓冲机制 | proxy_buffering off 导致每个响应均直接透传,Nginx worker 进程阻塞等待后端完成写入,并发能力受限 | 启用 proxy_buffering on,配置 proxy_buffer_size 16k、proxy_buffers 8×64k、proxy_busy_buffers_size 128k | Nginx worker 快速释放回连接池,并发处理能力显著提升 |
| 后端日志降级 | 每请求均输出 INFO 级别日志,bench:noop 等高频接口造成大量无效 IO 开销 | 将每请求 INFO 日志降为 debug 级别 | 减少大量无效磁盘 IO 和日志格式化 CPU 开销 |
| 后端 Toposort 缓存 | 每次请求均重新执行拓扑排序计算,热点配置场景下重复计算浪费 CPU | 引入 dirty 标记 + sortedSnapshot 缓存机制,配置未变更时直接返回缓存结果 | 消除重复拓扑排序计算,接口响应延迟显著降低 |
| 后端 IdpOauth 读侧免锁 | 读操作加锁导致高并发下线程争用,成为性能瓶颈 | 采用 volatile 只读快照实现读侧免锁,仅在写操作时加锁 | 高并发读场景下消除锁竞争,吞吐量大幅提升 |
三、核心模块详细优化对比
(一)Nginx 转发改动
优化前 Nginx upstream 连接池配置保守(keepalive 仅 32 连接),未配置负载均衡策略,无连接数复用上限和超时显式声明;/api/ location 关闭了 proxy_buffering,导致 Nginx worker 在等待后端响应期间被阻塞,无法高效复用。优化后从连接池容量、负载均衡策略、连接生命周期管理和响应缓冲四个维度进行全面调优。
优化前配置:
upstream aimom_pool {
    keepalive 32;
    server imom-aimom:80;
}

location /api/ {
    proxy_pass http://aimom_pool;
    proxy_http_version 1.1;
    proxy_set_header Host $http_host;
    proxy_set_header X-Forwarded-Host $http_host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_connect_timeout 300s;
    proxy_send_timeout 3600s;
    proxy_read_timeout 3600s;
    proxy_buffering off;
    proxy_cache off;
}
优化后配置:
upstream aimom_pool {
    least_conn;
    server imom-aimom:80;
    keepalive 256;
    keepalive_requests 10000;
    keepalive_timeout 300s;
}

# ====== API 类:开 buffering ======
location /api/ {
    proxy_pass http://aimom_pool;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
    proxy_set_header Host $http_host;
    proxy_set_header X-Forwarded-Host $http_host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Real-IP $remote_addr;

    proxy_buffering on;
    proxy_buffer_size 16k;
    proxy_buffers 8 64k;
    proxy_busy_buffers_size 128k;
    proxy_max_temp_file_size 0;
}
优化对比详情:
| 优化维度 | 旧版配置 | 新版配置 | 优化收益 |
|---|---|---|---|
| 负载均衡策略 | 未配置(默认轮询 round-robin) | least_conn | 将请求分配给当前活跃连接数最少的后端,避免负载不均 |
| keepalive 连接数 | 32 | 256 | 高并发下连接复用率提升 8 倍,减少 TCP 握手开销 |
| keepalive_requests | 未配置(默认 100) | 10000 | 单连接最大请求数大幅提升,减少连接重建频率 |
| keepalive_timeout | 未配置 | 300s | 空闲连接保活时间显式配置,避免过早断开 |
| Connection 头 | 未配置 | proxy_set_header Connection "" | 显式发送空 Connection 头,确保后端不主动关闭连接 |
| proxy_buffering | off | on | Nginx 收到后端响应后立即释放 worker,提升并发处理能力 |
| proxy_buffer_size | 未配置 | 16k | 存储响应头的首缓冲大小,适配 API 响应头尺寸 |
| proxy_buffers | 未配置 | 8×64k | 512k 总缓冲空间,避免后端响应写入时 Nginx 阻塞 |
| proxy_busy_buffers_size | 未配置 | 128k | 缓冲写满后向客户端刷数据的阈值,平衡内存与吞吐 |
| proxy_max_temp_file_size | 未配置(允许写磁盘) | 0 | 禁止写临时文件,全部在内存中完成,降低磁盘 IO |
(二)后端代码优化
优化后 aimom 后端在代码层进行了三项针对性优化,分别解决日志 IO 开销、重复计算和锁竞争三个性能瓶颈:
1. 每请求 INFO 日志降为 debug
高频接口(如 bench:noop)每次请求均输出 INFO 级别日志,在压测和正常调用场景下产生大量无效磁盘 IO 和字符串格式化开销。优化后将每请求日志级别从 INFO 降级为 debug,生产环境默认不输出 debug 日志,仅在排查问题时动态开启。
2. Toposort 结果缓存(dirty 标记 + sortedSnapshot)
优化前每次请求都会触发一次完整的拓扑排序计算,在配置未变更的场景下属于纯浪费。优化后引入脏标记(dirty flag)+ 排序快照(sortedSnapshot)机制:仅在配置变更时标记 dirty 并重新计算拓扑排序,后续请求直接复用缓存结果,将 O(N·logN) 的计算降为 O(1) 的缓存命中。
3. IdpOauth 读侧免锁(volatile 只读快照)
优化前 IdpOauth 模块的读操作在同步锁保护下执行,高并发读场景下大量线程争用同一把锁,成为吞吐量瓶颈。优化后采用 volatile 只读快照方案:读操作直接读取 volatile 引用的不可变快照对象(无锁),仅在写操作(配置更新)时加锁替换快照引用,实现读写分离,读侧零锁开销。
四、优化效果总结
通过本次 aimom 后端 [GET] /api/bench:noop 接口的系统性优化,从 Nginx 网关转发层和后端服务代码层两个维度协同发力,整体效果如下:
(1)Nginx 连接池强化:keepalive 连接数从 32 扩容至 256,启用 least_conn 负载均衡策略,配合 keepalive_requests 和 keepalive_timeout 显式配置,连接复用率和负载均衡均匀度大幅提升,有效减少 TCP 三次握手开销。
(2)Nginx 响应缓冲启用:将 proxy_buffering 从 off 调整为 on,配合精细化的缓冲区参数配置,Nginx worker 在收到后端响应后可快速释放回连接池处理下一个请求,并发处理能力显著提升。
(3)后端日志降级:每请求日志从 INFO 降为 debug,消除高频接口场景下的大量无效 IO 和 CPU 开销。
(4)后端 Toposort 缓存:通过 dirty 标记 + sortedSnapshot 机制消除重复拓扑排序计算,配置不变时接口响应从计算密集型降为内存读取型。
(5)后端读侧免锁:IdpOauth 模块读操作通过 volatile 只读快照实现无锁读取,消除高并发下锁争用瓶颈,吞吐量大幅提升。
Nginx 网关层与后端代码层优化相互配合、形成完整链路:网关层提升连接复用与转发效率,后端层减少单次请求的计算与锁开销,两端协同实现接口响应延迟的压降。
五、优化结果压测对比
优化前:
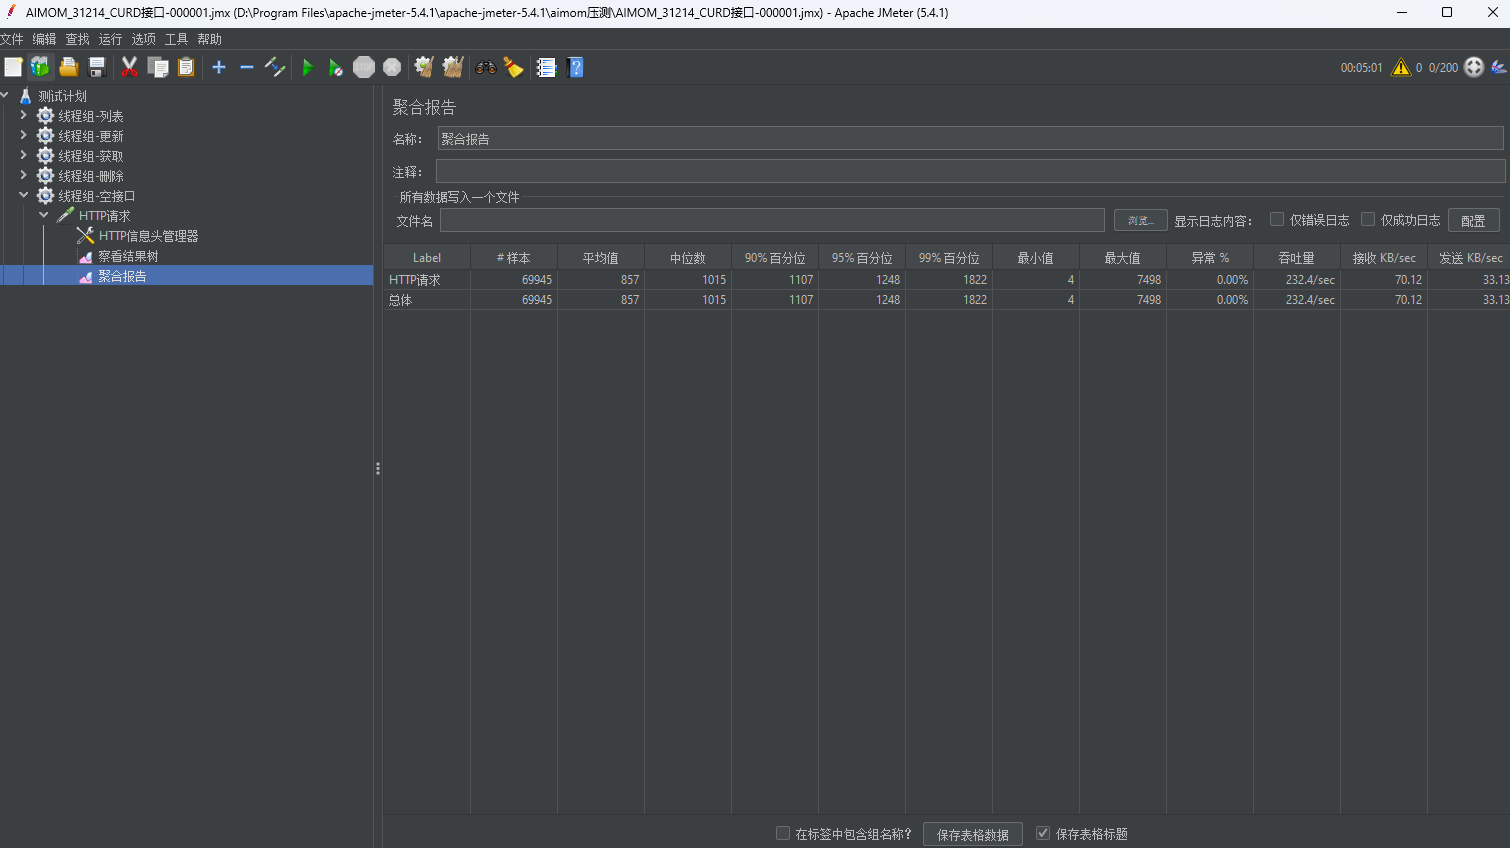
吞吐量: 232/sec
优化后:
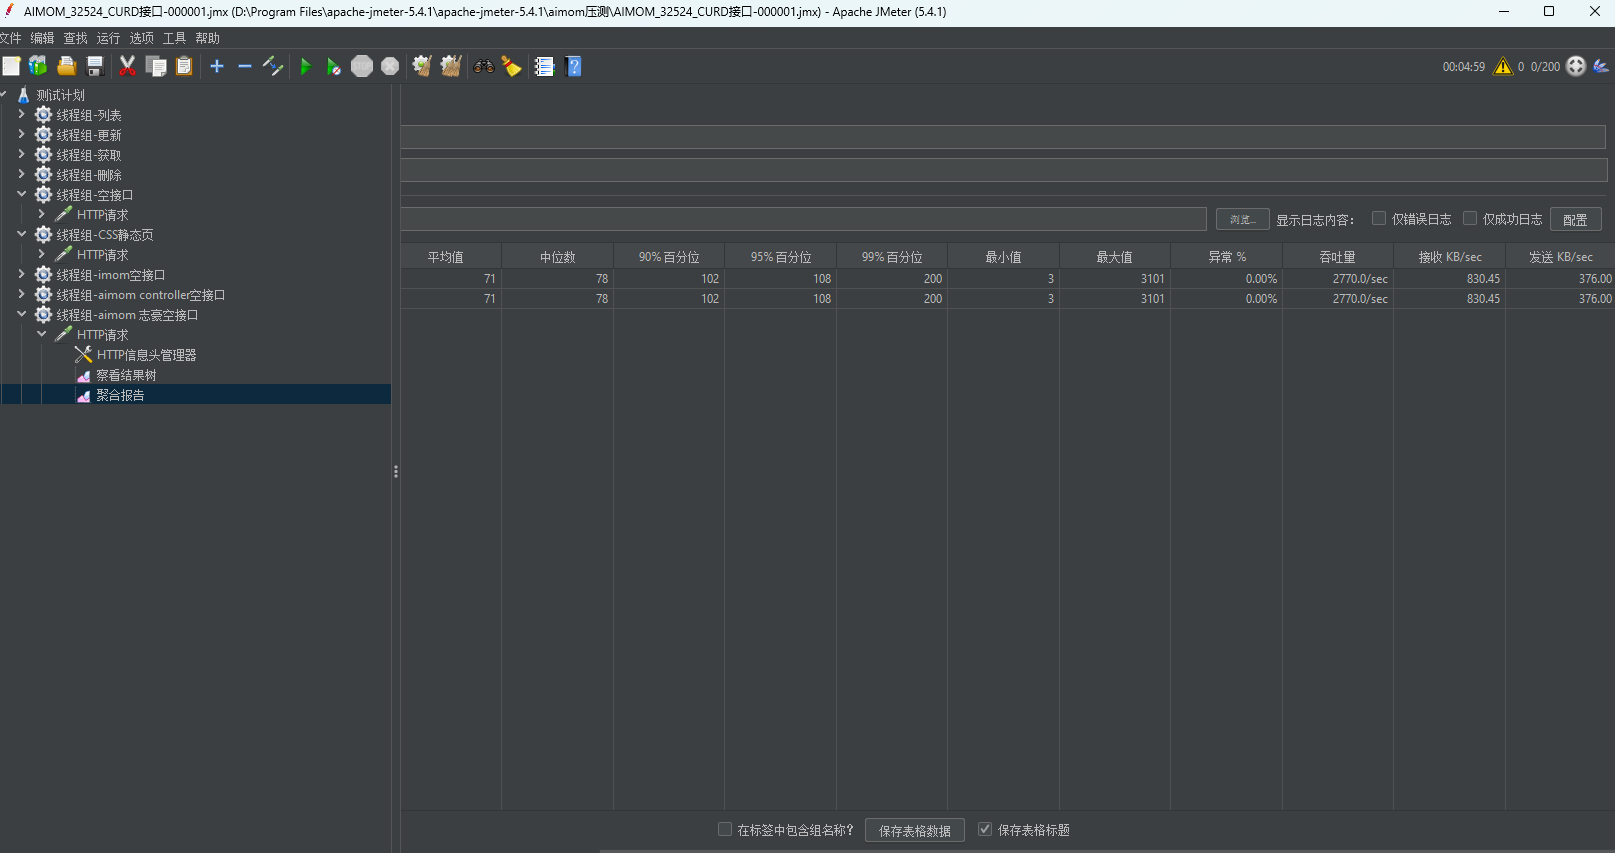
吞吐量: 2770/sec
六、经验总结
通过本次 aimom 后端接口性能优化的实践,沉淀出以下核心经验:
(1)连接池参数精细化:upstream keepalive 仅设置连接数是不够的,还需配合 keepalive_requests(单连接最大请求数)和 keepalive_timeout(空闲超时)进行精细化配置,同时通过 least_conn 负载均衡策略避免单节点过载。
(2)proxy_buffering 场景化:API 类请求应开启 proxy_buffering 提升并发能力;WebSocket、大文件下载等流式场景才需要关闭 buffering。需按请求类型区分配置。
(3)日志分级纪律:高频接口的请求日志必须使用 debug 级别,INFO 级别应仅用于关键业务节点。日志格式化与磁盘写入的开销在高并发下不可忽略。
(4)计算结果缓存模式:对于"读多写少"的计算型场景(如拓扑排序),dirty 标记 + 快照缓存是最有效的优化手段,将重复计算降为缓存命中。
(5)读写分离免锁:高并发读场景下,使用 volatile 不可变快照替代同步锁是经典的无锁化方案,读操作零开销,写操作仅在快照替换时短暂加锁。